

ArcGIS Pro читає документи за вас: що змінює ШІ у роботі з технічними даними
Що, як ArcGIS Pro зможе сам прочитати технічні звіти, акти обстежень, журнали, інспекційні форми та іншу документацію вашого проєкту - і перетворити потрібну інформацію на готові просторові дані?
Сотні сторінок можуть містити глибини, характеристики об’єктів, результати обстежень, польові спостереження, дані про стан мереж чи обладнання. Сьогодні, щоб використати цю інформацію в GIS, фахівцям часто доводиться відкривати документи один за одним, знаходити потрібні значення та переносити їх вручну. Штучний інтелект в ArcGIS Pro дозволяє автоматизувати цю роботу: модель аналізує документацію, знаходить визначені характеристики, структурує їх і перетворює на дані, які можна одразу аналізувати та відображати на карті. У результаті архів технічної документації стає джерелом даних для вебкарт, інформаційних панелей, застосунків і 3D-сцен.
На прикладі інженерно-геологічних журналів розглянемо, як це працює на практиці та як такий підхід можна адаптувати до інших типів документації.
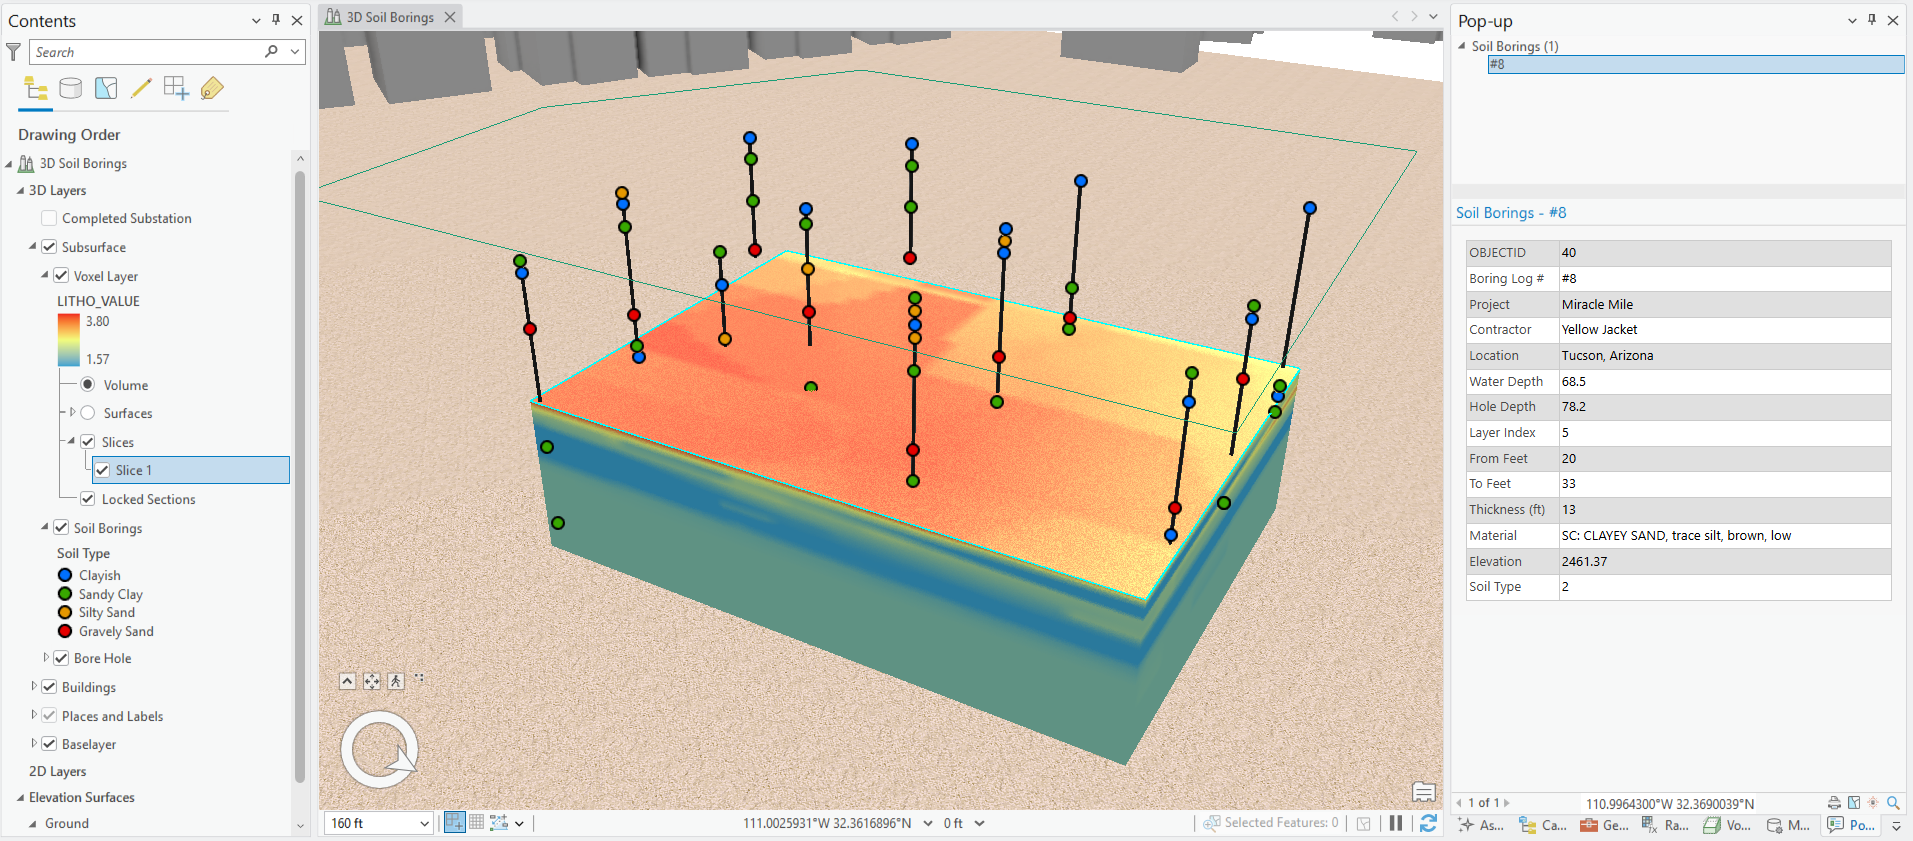
Інженерно-геологічні дані, автоматично вилучені з PDF та представлені на карті в ArcGIS.
Джерело: Esri
Як ШІ перетворює документ на дані в ArcGIS
Один із прикладів такого підходу - автоматична обробка інженерно-геологічних журналів свердловин.
Кожна свердловина має координати та вертикальний профіль ґрунтів. У журналі можуть міститися дані про глибину, типи й класифікацію ґрунтів, характеристики окремих шарів, польові спостереження, наявність гравію або валунів, а також глибину, на якій буріння було зупинено. Традиційно такі дані потрібно переносити вручну.
За допомогою ШІ цей процес можна побудувати інакше:
PDF-документ → модель ШІ → структуровані дані → просторовий шар ArcGIS.
Модель аналізує документ, знаходить необхідну інформацію та повертає її у визначеній структурі. ArcGIS Pro використовує отримані дані для формування об’єктів і їхніх атрибутів. У результаті кожна точка свердловини на карті може містити повний профіль: типи ґрунтів, глибини шарів, класифікаційні коди та іншу інформацію з оригінального документа - без ручного введення кожного значення.
Як ArcGIS Pro працює з мовними моделями
Для обробки текстової інформації за допомогою ШІ в ArcGIS Pro використовується інструмент Process Text Using AI Model із набору інструментів GeoAI та фреймворк Text Analysis для роботи зі сторонніми мовними моделями.
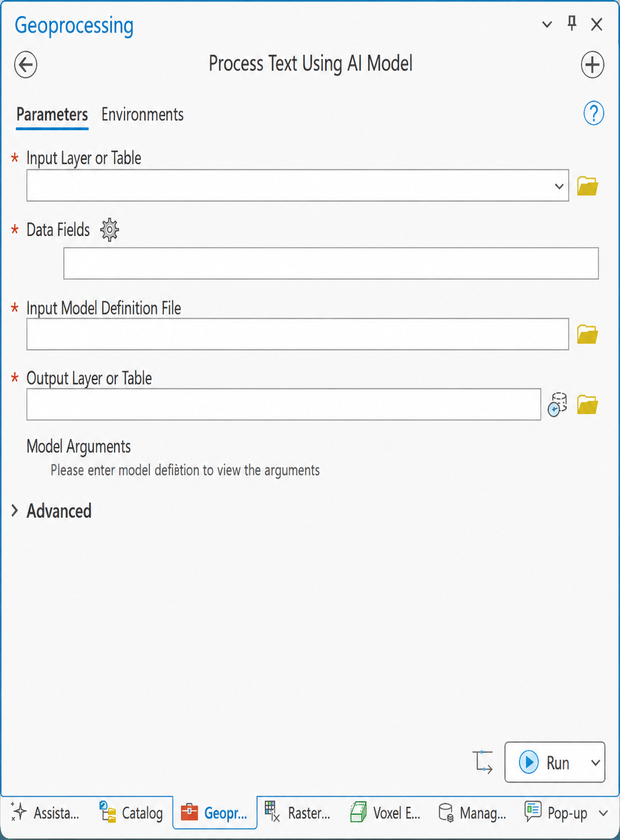
Інструмент Process Text Using AI Model в ArcGIS Pro та параметри налаштування моделі.
Джерело: Esri
Фреймворк дозволяє Python-розробникам створювати власні функції обробки природної мови (NLP) та підключати ArcGIS до зовнішніх мовних моделей. Це може бути модель із відкритим вихідним кодом або комерційна LLM, доступна через веб-API. Логіка такої взаємодії упаковується у пакет глибокого навчання Esri - .dlpk, який потім використовується стандартними інструментами текстового аналізу ArcGIS Pro.
При роботі через веб-API пакет не обов’язково прив’язувати до одного постачальника LLM. Його можна налаштувати для роботи з Anthropic, OpenAI, Google Gemini або Azure OpenAI. Постачальник і модель обираються під час запуску, а відповідний API-ключ передається користувачем окремо та не зберігається у пакеті.
Зміна постачальника не потребує зміни самої логіки вилучення інформації: змінюється сервіс, до якого надсилається запит, тоді як промпт, обробка результату та структура вихідних даних можуть залишатися тими самими.
Важливо: для використання цієї можливості потрібен рівень ліцензії Advanced. Якщо використовується LLM через веб-API, інформація, що обробляється, передається відповідному постачальнику моделі. Тому перед використанням необхідно врахувати політику роботи з даними організації та умови обраного сервісу. Python- та .dlpk-файли слід запускати лише з надійних джерел.
Як влаштований пакет .dlpk
Користувацький .dlpk - архів, що містить два основні компоненти:
файл визначення моделі Esri .emd;
Python-файл із логікою inference.
У .emd параметр InferenceFunction визначає Python-файл, у якому знаходиться логіка обробки, а ModelType вказує тип завдання, для якого призначена модель.
Щоб створити .dlpk, .emd і Python-файл розміщуються у папці з тією самою назвою, що й .emd. Папка стискається в ZIP-архів, після чого розширення файлу змінюється на .dlpk. ArcGIS Pro використовує інформацію з .emd, щоб отримати доступ до Python-коду та виконати його під час роботи інструмента.
Важливо також враховувати версію ArcGIS Pro. У попередніх збірках помилка може виникнути ще на етапі перевірки інструмента до запуску коду. Тому пакет варто тестувати саме на тій версії ArcGIS Pro, у якій він надалі використовуватиметься.
Пакет також можна запускати з ArcGIS Pro Notebook — у такому разі діалогове вікно інструмента не використовується.
П’ять методів, які визначають роботу моделі
Python inference class містить п’ять основних методів. Вони відповідають послідовним етапам одного запуску — від визначення моделі та її параметрів до обробки документа й повернення готового FeatureSet.
__init__
__init__ задає ідентичність класу: його назву та короткий опис завдання.
Для обробки технічних PDF це, наприклад, може бути вилучення структурованої інформації з документів, пов’язаних з об’єктами у feature class.
initialize
initialize відповідає за завантаження моделі та отримує шлях до .emd, щоб прочитати збережену в ньому конфігурацію.
Для локальної моделі на цьому етапі можуть завантажуватися її навчені ваги. Якщо використовується модель, доступна через веб-API, локальне завантаження ваг не потрібне.
getParameterInfo
getParameterInfo визначає параметри, які користувач бачить у Model Arguments у панелі геообробки ArcGIS Pro.
Кожен параметр задається разом із назвою, типом даних, значенням за замовчуванням та інформацією про те, чи є він обов’язковим.
Через ці параметри можна передавати:
постачальника мовної моделі;
API-ключ;
основну модель;
резервну модель;
endpoint для Azure;
розмір блоку сторінок для великих PDF;
альтернативний промпт;
альтернативну схему вихідних даних.
Це дає можливість змінювати значну частину налаштувань без необхідності відкривати та перебудовувати .dlpk.
getConfiguration
Після отримання параметрів getConfiguration визначає, як виконуватиметься конкретний запуск. Метод зчитує вибраного постачальника, основну та резервну моделі, отримує API-ключ і визначає необхідний endpoint. Для Anthropic, OpenAI, Gemini та Azure використовуються відповідні endpoint, заголовки автентифікації та формати запитів і відповідей. При цьому промпт, парсинг результату та структура вихідних даних можуть залишатися незмінними.
Тут також задається batch size - кількість записів, які передаються моделі за один раз. Це значення можна змінювати відповідно до особливостей документів та обмежень сервісу.
predict
predict виконує основну обробку.
Метод отримує FeatureSet із вхідними записами та назву поля, у якому знаходяться вхідні дані, а повертає FeatureSet із результатами. Якщо вхідні записи посилаються на PDF, послідовність роботи може виглядати так:
PDF → кодування документа → передавання LLM разом з інструкціями → отримання структурованої відповіді → парсинг → формування FeatureSet.
Саме структура, яку повертає predict - поля та їх типи - визначає, які дані з’являться у вихідному feature class.
Як адаптувати модель під свої документи
Ключовими елементами для адаптації такого .dlpk під конкретний тип документа є промпт вилучення даних та схема вихідних даних. Промпт визначає, який документ аналізує модель і яку саме інформацію вона повинна знайти. Саме тут описується предметна специфіка: необхідні поля, класифікації, інтервали, характеристики та правила їх інтерпретації. Тому при переході від одного типу документа до іншого не обов’язково заново створювати всю інтеграцію з мовною моделлю. Можна змінити інструкції відповідно до структури нового документа. Наприклад, для інженерно-геологічного журналу промпт може визначати поля заголовка, класифікаційні коди, інтервали глибин і описи шарів. Для інспекційної форми або технічного звіту набір необхідних характеристик буде іншим.
Схема вихідних даних визначає поля, які predict формує у FeatureSet. Відповідно, саме вона визначає структуру майбутньої таблиці атрибутів.
Якщо необхідно отримувати додаткову характеристику, її можна додати до схеми та визначити, як значення з відповіді моделі має заповнювати відповідне поле.
Окремо можна налаштовувати список параметрів, конфігурацію, основну та резервну моделі й batch size. Але саме можливість змінювати промпт і схему дозволяє адаптувати один механізм роботи з LLM до різних типів технічної документації без повторного створення всієї інтеграції. Для різних форматів документів можна сформувати бібліотеку окремих промптів і використовувати відповідний набір інструкцій залежно від типу документа.
Як працювати з великими PDF
Якщо один PDF містить великий обсяг інформації, структурована відповідь LLM може не вміститися в одну відповідь і бути обрізаною. Для цього передбачено налаштування поділу документа на блоки сторінок. Великий PDF розділяється на менші діапазони, кожен із них аналізується окремо, після чого отримані записи об’єднуються.
Розмір блоку варто задавати відповідно до логічної структури документа. Наприклад, якщо один журнал свердловини займає кілька сторінок, блок має охоплювати приблизно таку кількість сторінок, щоб дані однієї свердловини не були розділені між двома запитами.
Які технічні документи можна обробляти за допомогою ШІ
Головна перевага такого підходу полягає в тому, що рішення не обмежується одним типом документа. Логіку вилучення інформації визначають передусім промпт та структура вихідних даних. У промпті можна описати, який саме документ аналізує модель та які поля необхідно знайти. Тому той самий підхід можна адаптувати до багатьох типів документації.
Наприклад:
актів технічних обстежень;
інспекційних форм;
виконавчої документації;
екологічних звітів;
документів щодо стану інженерних мереж;
звітів про об’єкти інфраструктури;
архівної технічної документації;
результатів польових досліджень.
Таким чином, цінна інформація, яка раніше залишалася всередині PDF-файлів, може стати частиною корпоративної GIS.
Наскільки точним може бути вилучення даних
Автоматизація роботи з технічною документацією не скасовує необхідність контролю даних. У прикладі з інженерно-геологічними журналами було протестовано десять свердловин. Результати, отримані моделлю, порівнювалися з вихідними PDF-документами.
Для всіх десяти свердловин модель правильно визначила:
послідовність шарів ґрунту;
класифікаційні коди;
кількість шарів;
загальну глибину свердловини.
Загалом було перевірено 49 окремих шарів ґрунту.
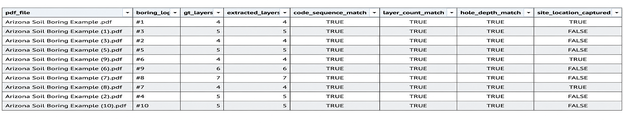
Перевірка точності вилучення даних: результати для 10 свердловин порівняно з вихідними PDF-документами.
Джерело: Esri
Водночас один із параметрів - місце розташування - модель визначала непослідовно. Причина полягала у структурі самого документа: у ньому використовувалися два різні поля з однаковою назвою Location. Проблему можна було усунути, уточнивши інструкцію для моделі. Цей приклад показує важливий принцип роботи з генеративним ШІ: якість результату залежить не лише від самої моделі, а й від того, наскільки однозначно сформульоване завдання та наскільки ретельно результати перевіряються на вихідних даних.
Як масштабувати обробку документів на рівень організації
Обробка PDF у ArcGIS Pro може бути лише першим етапом. Оскільки Process Text Using AI Model є інструментом геообробки, створений робочий процес можна опублікувати як сервіс геообробки в ArcGIS Enterprise. Це відкриває можливості для подальшої автоматизації. Наприклад, процес можна налаштувати так, щоб:
новий документ з’явився у визначеному сховищі → модель автоматично його опрацювала → необхідні дані були вилучені → просторовий шар оновився.
Такий сервіс може запускатися за розкладом, бути частиною більшого автоматизованого процесу або працювати з новими документами в міру їх надходження.
Крім створення таблиці або шару, Python-код усередині .dlpk може виконувати й наступні операції з даними. Наприклад:
публікувати hosted feature layer;
додавати інформацію до існуючого набору даних;
позначати записи, які потребують перевірки фахівцем;
передавати результати до подальших GIS-процесів.
У результаті обробка документа та використання отриманої інформації можуть відбуватися в єдиному середовищі ArcGIS.
Де такий підхід може бути корисним
Такий підхід особливо актуальний для організацій, які накопичили великі архіви технічної документації. Наприклад, у сфері будівництва це можуть бути результати інженерних вишукувань та акти обстежень. Для підприємств водопостачання й теплопостачання - документи щодо стану мереж та обладнання. В енергетиці - звіти про об’єкти інфраструктури та результати інспекцій. Для громад - архівна документація щодо комунальних і міських об’єктів.
Замість того щоб залишатися окремими файлами в архіві, ці відомості можуть бути перетворені на просторові дані та використовуватися у вебкартах, інформаційних панелях, застосунках і 3D-сценах.
ШІ автоматизує рутину - експертиза залишається за фахівцем
Штучний інтелект не замінює інженера, аналітика або фахівця, який відповідає за інтерпретацію даних. Первинний документ також залишається джерелом інформації. Завдання ШІ в цьому сценарії - прибрати значну частину рутинної роботи: читання однотипних документів, пошук потрібних значень і ручне перенесення даних. Фахівець отримує структуровану інформацію та може зосередитися на її перевірці, просторовому аналізі й прийнятті рішень.
Саме так архіви технічних PDF-документів можуть перетворитися з пасивного сховища інформації на повноцінне джерело даних для GIS.
Більше про практичні можливості GIS + AI говоритимемо 13–14 жовтня на 25-й Міжнародній конференції користувачів ArcGIS «GIS + AI: Нові горизонти розвитку»
 Реєстрація
ECOMM як офіційний партнер Esri в Україні допомагає впроваджувати рішення ArcGIS для автоматизації роботи з просторовими даними, інтеграції GIS у корпоративні процеси та використання сучасних можливостей GeoAI. Якщо у вашій організації накопичено значний обсяг технічної документації, її можна перетворити на структуровані просторові дані та використовувати для подальшого аналізу, візуалізації й прийняття юрішень.
Далі ви можете ознайомитися з: